
La previsione della domanda nel retail è la stima operativa delle unità che venderai in un periodo futuro. Fatta correttamente riduce stockout e giacenze in eccesso, liberando capitale circolante. I modelli tree-based come LightGBM sono diventati lo standard pratico per grandi panel di dati, ma servono governance e coerenza tra i livelli aggregati per trasformarli in decisioni utili.
In breve:
- La previsione della domanda nel retail deve considerare variazioni settoriali e la diversità tra canali online e fisici, per evitare modelli generici fallimentari.
- I modelli tree-based come LightGBM sono preferibili su grandi dataset, mentre metodi come Croston sono indispensabili per domande intermittenti a elevata sporadicità.
- Una buona qualità dei dati, come transazioni dettagliate e promozioni correttamente datate, è essenziale per ottenere previsioni affidabili e utili.
- La riconciliazione gerarchica delle previsioni tra livello SKU, negozio e categoria è fondamentale per pianificare ordini coerenti e accurate.
- La misurazione dell’effettivo livello di servizio clienti, attraverso il fill rate, è più significativa di errori statistici come MAE o sMAPE per migliorare margini e soddisfazione.
Indice
- Perché la previsione della domanda è critica per operazioni e margini
- Metodi e modelli: guida pratica a statistiche, ML e metodi per domanda intermittente
- Dati e feature: quali sorgenti servono e come ingegnerizzarle
- Pipeline operativa e governance: come costruire un flusso affidabile e coerente
- Metriche operative: misurare cosa conta
- Errori comuni e checklist di best practice per evitare bias e rotture di stock
- Prospettiva dell’autore: dall’implementazione alle metriche di business
- SoftShop come supporto operativo alla previsione della domanda
- Fonti
- Domande frequenti
Perché la previsione della domanda è critica per operazioni e margini
Uno stockout non è solo una vendita persa: è un cliente che prova un altro negozio o un altro canale, con un effetto che dura più del singolo episodio. All’estremo opposto, l’overstock immobilizza liquidità in scorte che spesso finiscono in svendita, comprimendo il margine.
I dati ISTAT di luglio 2026 mostrano variazioni congiunturali e tendenziali diverse tra alimentari e non alimentari, un segnale che i pattern di domanda si muovono in modo disomogeneo tra categorie e che un modello unico per tutto l’assortimento rischia di sbagliare proprio dove il mercato cambia più in fretta.
L’omnicanalità aggrava il problema: un cliente che ordina online e ritira in negozio genera una domanda che va riconciliata tra magazzino fisico e digitale. Le previsioni inaccurate causano effetti concreti tra cui:
- Rotture di stock ricorrenti sulle referenze più vendute nei periodi promozionali.
- Capitale immobilizzato in scorte a lenta rotazione che occupano spazio e liquidità.
- Piani di assortimento sbagliati, con referenze introdotte o eliminate sulla base di segnali di domanda distorti.
Metodi e modelli: guida pratica a statistiche, ML e metodi per domanda intermittente
La scelta del metodo dipende dalla granularità e dalla forma della domanda. Per serie continue e con pochi punti storici, exponential smoothing o ARIMA restano scelte solide: richiedono poca ingegnerizzazione e funzionano bene a livello aggregato (categoria, negozio).
Quando il panel è ampio, con migliaia di combinazioni store per SKU e feature ricche (prezzo, promozioni, calendario), i modelli tree-based emergono come opzione pragmatica. La competizione M5 ha mostrato che modelli tree-based come LightGBM sono tra i migliori su larga scala, mentre metodi statistici più semplici possono restare competitivi a livello molto granulare, dove i dati sono scarsi.
Per la domanda intermittente, cioè serie con molti zero e picchi sporadici (tipica di ricambi, prodotti stagionali di nicchia o articoli a rotazione lenta), i metodi standard falliscono perché tendono a smussare i picchi. Qui entrano in gioco:
- Metodo di Croston e sue varianti, che separano la probabilità di occorrenza dalla quantità venduta.
- SBA (Syetsma Boylan Approximation), una correzione del bias strutturale di Croston.
- Hurdle models, che modellano occorrenza e quantità come due problemi distinti.
Un consiglio non richiesto, ma utile: raggruppare le serie per store o categoria prima di allenare un modello tree-based riduce il rumore delle serie più sparse e permette al modello di apprendere pattern condivisi, come indicato dagli studi collegati alla competizione M5.
Una ricerca del 2026 su arXiv ha analizzato il comportamento di metodi di previsione su contesti industriali intermittenti, mostrando che il ranking di accuratezza statistica e quello di livello di servizio possono invertirsi: un modello più accurato sulla carta non garantisce automaticamente un fill rate migliore, secondo lo studio arXiv.
Dati e feature: quali sorgenti servono e come ingegnerizzarle
Una previsione affidabile parte dalla qualità dei dati in ingresso, non dal modello scelto. Le sorgenti essenziali sono lo storico delle transazioni, i prezzi effettivi (non solo di listino), il calendario promozionale, i livelli di inventario e, per categorie sensibili come abbigliamento o giardinaggio, dati meteo.
- Raccogli storico transazionale a livello di singola vendita, non solo aggregato giornaliero, per poter ricostruire pattern orari e stagionali.
- Integra il calendario promozionale con date di inizio e fine esatte: una promozione mal datata contamina la feature e falsa l’apprendimento.
- Applica un quality-check sistematico prima di ogni training, scartando resi anomali, vendite a prezzo zero e duplicati.
- Costruisci feature con split temporale rigoroso: lag di vendita, medie mobili (rolling) e interazioni store per SKU, calcolate sempre usando solo dati disponibili prima della data target, per evitare leakage.
Pipeline operativa e governance: come costruire un flusso affidabile e coerente
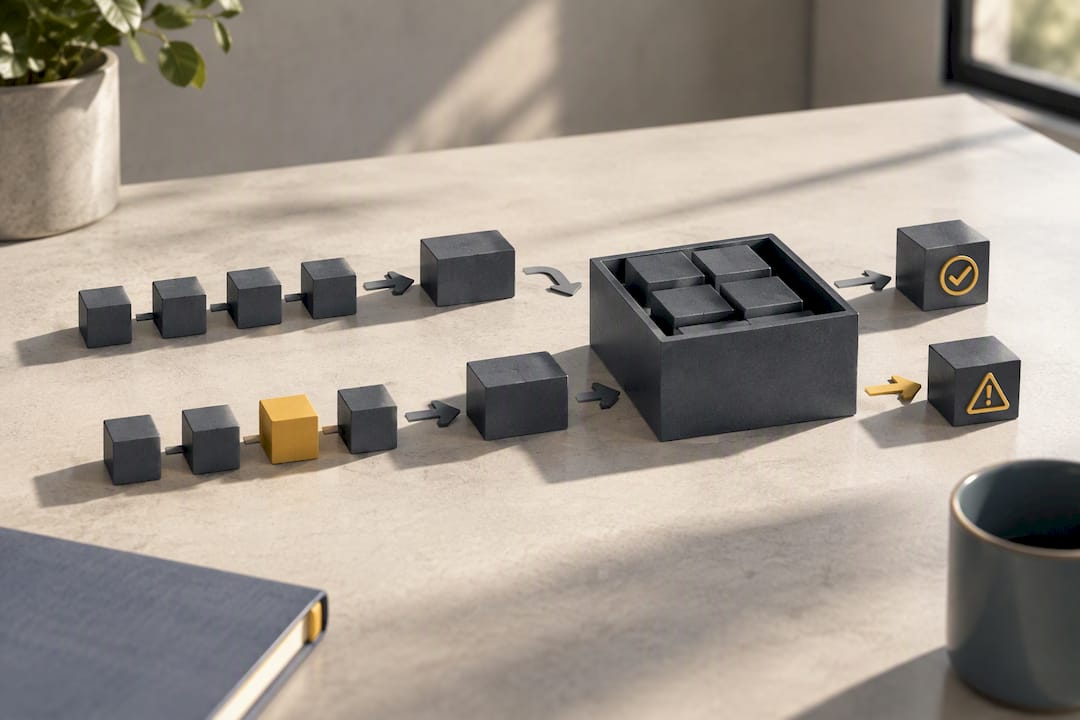
Un flusso di previsione utile alle decisioni segue una sequenza precisa, dall’ingestione dei dati alla pubblicazione del forecast.
- Ingest: raccolta automatica di vendite, scorte, prezzi e calendario da fonti POS ed ERP.
- Validazione: controlli di qualità e coerenza sui dati grezzi prima di ogni elaborazione.
- Feature engineering causal-safe: costruzione di lag e medie mobili senza usare informazioni future.
- Split temporale: separazione tra periodo di addestramento e periodo di verifica che rispetta l’ordine cronologico.
- Training e forecast: addestramento del modello e generazione delle previsioni per l’orizzonte richiesto.
- Riconciliazione gerarchica: allineamento delle previsioni tra livello SKU, negozio, categoria e totale aziendale.
- Pubblicazione: rilascio del forecast ai sistemi di ordering e replenishment.
La riconciliazione gerarchica, detta anche coherence, è un passaggio critico ma spesso trascurato. Senza di essa, le previsioni a livello di negozio, categoria e totale aziendale possono risultare incoerenti, rendendo impossibile costruire piani di ordine affidabili, come evidenziato nella documentazione di un sistema di demand planning open source.
Un consiglio: prima di collegare il forecast ai sistemi di riordino automatico, controlla sempre che la somma delle previsioni per SKU corrisponda alla previsione aggregata a livello di categoria: eventuali scostamenti indicano problemi di riconciliazione più che di modello.
Metriche operative: misurare cosa conta
MASE e sMAPE sono metriche statistiche comuni per confrontare modelli su diverse serie, ma non esprimono l’impatto sul cliente. Per questo, metriche operative come fill rate e COFR (customer order fill rate) sono necessarie per misurare il livello di servizio reale.
- MASE e sMAPE confrontano l’errore del modello rispetto a una baseline semplice, utili per lo sviluppo tecnico.
- Fill rate e COFR misurano l’esperienza reale del cliente e vanno collegati ai livelli di scorta di sicurezza.
- Il bias sistematico (previsioni sempre più basse o più alte del venduto reale) è spesso più dannoso dell’errore casuale, perché si accumula nel tempo.
Uno studio su arXiv del 2026 ha rilevato che correzioni di bias possono migliorare il fill rate senza bisogno di un nuovo addestramento del modello, come indicato nella ricerca su forecast e inventory. Questo significa che ottimizzare solo l’errore statistico non basta: bisogna tradurre l’errore in un costo o in un livello di servizio comprensibile a chi gestisce gli ordini.
Errori comuni e checklist di best practice per evitare bias e rotture di stock
Gli errori più frequenti nascono da problemi di processo più che di modello. Riconoscerli in tempo evita mesi di previsioni distorte.
- Leakage temporale: feature costruite con dati non disponibili al momento della previsione, la causa più comune di risultati troppo buoni per essere vero in test.
- Dati sporchi non filtrati: resi, storni e vendite anomale che entrano nel training senza pulizia.
- Metriche fuorvianti: ottimizzare solo l’errore statistico ignorando l’effetto sul fill rate.
Un consiglio: pianifica un audit trimestrale del forecasting, non solo quando qualcosa va storto: i bias si accumulano lentamente e passano inosservati fino a diventare costosi.
Checklist rapida in sei punti: verifica la presenza di leakage nelle feature, controlla la qualità dei dati sorgente, misura il bias medio per categoria, confronta fill rate reale e previsto, testa la coerenza gerarchica prima della pubblicazione, documenta ogni modifica al modello prima del rilascio.
Prospettiva dell’autore: dall’implementazione alle metriche di business
La previsione della domanda smette di essere un esercizio accademico solo quando viene collegata a un sistema che gestisce ordini e scorte ogni giorno. È qui che molte aziende si bloccano: hanno un modello statisticamente valido, ma nessun ponte verso l’operatività quotidiana.
Un gestionale che centralizza vendite, scorte e riordini può facilitare la trasformazione di una previsione in un ordine di acquisto concreto, riducendo passaggi manuali che potrebbero introdurre ritardi e errori. La parte più sottovalutata del processo non è il modello, ma la disciplina nel mantenere i dati puliti e i flussi coerenti nel tempo.
— Stefano
SoftShop come supporto operativo alla previsione della domanda
Una previsione accurata serve a poco se poi resta scollegata dal magazzino reale. SoftShop integra controllo delle giacenze in tempo reale, gestione multi-magazzino e collegamento diretto con l’eCommerce, così i numeri del forecast si traducono subito in ordini e riordini senza passaggi manuali.

- Scorte in tempo reale su più depositi, utile per verificare la coerenza tra previsione e disponibilità effettiva.
- Integrazione eCommerce per riconciliare domanda online e in negozio nello stesso sistema.
- Backup automatici e supporto tecnico utile per chi gestisce dati critici di vendita.
Un buon punto di partenza è un pilot su un gruppo ristretto di SKU critici, prima di estendere il processo a tutto l’assortimento. Puoi provare SoftShop gratuitamente per 30 giorni senza obbligo d’acquisto e valutare i piani Single PC, Multi PC o Cloud più adatti alla tua struttura.
Fonti
Per approfondire i metodi citati, la competizione M5 resta il riferimento tecnico principale, insieme ai dati di mercato ISTAT e allo studio arXiv 2026 su forecast e inventory. Per la gestione pratica dell’omnicanalità, utile anche l’approfondimento di Baby Love Growth sull’esperienza cliente integrata, e la guida SoftShop sulla logistica per l’eCommerce.
- ScienceDirect - studio su modelli per forecasting (M5 benchmark)
- Gadiel-Analytics/demand-forecasting-system (README)
- ISTAT – Comunicato commercio al dettaglio luglio 2026
- ArXiv 2026 — studio su forecast–inventory interaction e bias
Domande frequenti
Quali sono le tendenze per il futuro del settore retail?
I dati ISTAT più recenti mostrano andamenti differenziati tra categorie alimentari e non alimentari, segno che la domanda si muove in modo sempre più frammentato tra canali e segmenti. Le aziende che integrano previsione e gestione delle scorte in un unico sistema riescono a reagire più in fretta a questi cambiamenti.
Quali sono le previsioni per il settore della moda?
Il settore moda è tra i più sensibili a stagionalità e intermittenza della domanda, dove metodi come il metodo di Croston o gli hurdle models spesso danno risultati migliori dei modelli statistici classici. Non esiste un dato univoco di crescita per il settore: l’attenzione operativa dovrebbe restare sulla gestione delle collezioni a rotazione rapida.
Che differenza c’è tra budget e forecast?
Il budget è un obiettivo finanziario stabilito a inizio periodo, spesso legato a target commerciali e di margine. Il forecast è una stima aggiornata della domanda futura basata sui dati più recenti disponibili, e i due possono divergere in modo significativo durante l’anno.
Cosa si intende per mercato retail?
Il mercato retail comprende l’insieme delle attività di vendita di beni al consumatore finale, sia tramite negozi fisici sia tramite canali digitali. Comprende categorie molto diverse tra loro, dall’alimentare all’abbigliamento, ciascuna con dinamiche di domanda e stagionalità proprie.
Commenti
Nessun commento ancora. Sii il primo a commentare!
Lascia un Commento